레이블이 STATISTICS_BASE_DATA_ANALYSIS인 게시물을 표시합니다. 모든 게시물 표시
레이블이 STATISTICS_BASE_DATA_ANALYSIS인 게시물을 표시합니다. 모든 게시물 표시
2021년 10월 27일 수요일

Day_06. 평균비교 & Logistic Regression
모집단이 2개인 경우
=독립인 집단에서 차이 검정
=평균 차이 검정
집단이 3개 이상일 때
=독립적 집단이 3개 이상일 때 평균 비교 방법
==2개씩 짝을 지어 비교한다
=마케팅 부분에서 주로 사용한다 -> 고객에게 만족을 주는가 -> 의사결정이 가능한가
일원배치 분산 분석
=동질성 파악이 중요
=분산=편차 제곱의 합의 평균
=표준편차 = 분산의 제곱근
가설
=귀무가설(영가설) – 모든 집단의 처리의 평균이 같다 , 각 처리의 효과가 없다
=대안가설(연구가설) – 평균의 차이가 있는 것으로 적어도 한 개 처리의 평균이 다르다
독립표본 T검증 – 2개 집단의 평균의 차이(
일원배치 분산 분석 = 3개 이상의 특성
===국내 대학생의 취업 태도/취업 준비 비용에 대한 연구
인공지능과 통계의 관계
==통계를 모르고 인공지능을 할 수 없음
Logistic Regression
=Binomial Logistic Regression 결과값이 0,1 로 나옴, 종속변수가 이항
=결과값이 2개이상에서는 다항 Logistic Regression 을 이용한다
==장점
===모수 추정이 가능/범주 확률값의 추정 / 해석성이 좋다
==단점
===데이터 set의 차원이 크면 성능이 떨어진다
수업중 참조한 논문
=근로 경험이 취업에 미치는 영향 분석
=GOMS 공공데이터를 사용했음
공공데이터의 특징
=범위가 BROAD 해서 데이터의 INSIGHT를 추출하는 방법이 쉽지 않음
=독립인 집단에서 차이 검정
=평균 차이 검정
집단이 3개 이상일 때
=독립적 집단이 3개 이상일 때 평균 비교 방법
==2개씩 짝을 지어 비교한다
=마케팅 부분에서 주로 사용한다 -> 고객에게 만족을 주는가 -> 의사결정이 가능한가
일원배치 분산 분석
=동질성 파악이 중요
=분산=편차 제곱의 합의 평균
=표준편차 = 분산의 제곱근
가설
=귀무가설(영가설) – 모든 집단의 처리의 평균이 같다 , 각 처리의 효과가 없다
=대안가설(연구가설) – 평균의 차이가 있는 것으로 적어도 한 개 처리의 평균이 다르다
독립표본 T검증 – 2개 집단의 평균의 차이(
일원배치 분산 분석 = 3개 이상의 특성
===국내 대학생의 취업 태도/취업 준비 비용에 대한 연구
인공지능과 통계의 관계
==통계를 모르고 인공지능을 할 수 없음
Logistic Regression
=Binomial Logistic Regression 결과값이 0,1 로 나옴, 종속변수가 이항
=결과값이 2개이상에서는 다항 Logistic Regression 을 이용한다
==장점
===모수 추정이 가능/범주 확률값의 추정 / 해석성이 좋다
==단점
===데이터 set의 차원이 크면 성능이 떨어진다
수업중 참조한 논문
=근로 경험이 취업에 미치는 영향 분석
=GOMS 공공데이터를 사용했음
공공데이터의 특징
=범위가 BROAD 해서 데이터의 INSIGHT를 추출하는 방법이 쉽지 않음
Day_05. 평균분석
평균분석의 특징
=종속변수 – 수치형
=독립변수 – 명목형 청도
평균비교 사용처
=모집단이 두개
=서로 독립인 두 집단에서 평균 차이 검정
=서로 대응되는 두 집단에서 평균차이 검정
데이터 분석의 정의
=데이터-> 분석 -> 정보 -> 예측/분류/군집/시각화 ->올바른 의사결정->경쟁우위 ->생존
편차 = 평균선에서 멀어진 차이 – 편차의 합 = 0이 된다
모집단이 3개 이상인 곳에서 분석
=일원분산분석 EX)나이대별 의사결정
==군집에 따라 다른 특성을 보일 때
모집단이 두개인 집단
==서로 독립인 두집단
==대응을 이루는 집단
===각 집단을 변수에 의해 두개로 구분시 서로 영향을 주지 않는 집단
====분산이 동일해야 비교가 가능하다
===분산의 동질성 검증
평균 비교의 특징
=독립표본 T검증
=대응표본 T검증
검정순서
=두 집단의 독질성 섬증 (P값 기준 0.05미만 – 비 등분산 / 0.05이상 - 등분산
=종속변수 – 수치형
=독립변수 – 명목형 청도
평균비교 사용처
=모집단이 두개
=서로 독립인 두 집단에서 평균 차이 검정
=서로 대응되는 두 집단에서 평균차이 검정
데이터 분석의 정의
=데이터-> 분석 -> 정보 -> 예측/분류/군집/시각화 ->올바른 의사결정->경쟁우위 ->생존
편차 = 평균선에서 멀어진 차이 – 편차의 합 = 0이 된다
모집단이 3개 이상인 곳에서 분석
=일원분산분석 EX)나이대별 의사결정
==군집에 따라 다른 특성을 보일 때
모집단이 두개인 집단
==서로 독립인 두집단
==대응을 이루는 집단
===각 집단을 변수에 의해 두개로 구분시 서로 영향을 주지 않는 집단
====분산이 동일해야 비교가 가능하다
===분산의 동질성 검증
평균 비교의 특징
=독립표본 T검증
=대응표본 T검증
검정순서
=두 집단의 독질성 섬증 (P값 기준 0.05미만 – 비 등분산 / 0.05이상 - 등분산
Day_04. 중간고사 공지 & Regression
NCS 정의
=국가 직무능력 표준으로 업무를 진행하기 위해 필요한 사항을 모듈화 시킨 것
중간고사 공지
=NCS 코딩데이터에 대한 R-Studio 실습 – Coding + 설명
=Working directory 설정 잘해야 에러 없이 제출이 가능하니 주의
=coding 산출물은 코딩file, 주석은 워드에
=결과값은 캡쳐할 필요 없음
=문제 & 코딩 image 넣기
상관 분석 – correlation analysis
=상관- 확률과 통계학에서 두 변수간의 어떤 선형, 비선형 관계를 가지는지 분석하는 방법
=상관 관계 – 변수간의 강도
==강도의 크기 – 보통 피어슨 상관관계를 가진다
=회귀 분석에서의 비독립 – 독립 변수간 관계가 0.8 이상 다중 공선성 – 독립이 가정이 안됨
=회귀분석 전에 상관 분석을 해야한다
=변수간의 관계 수치를 파악해서 시작한다
Excel을 이용한 data 분석
=상관관계를 –에서 +까지 확인
수업 example – 한국 창업학회 11권 1호 정화민 2016논문
=소기업 소상공인을 대상으로 서울시 기업 지원 정책의 효과성 여부, 자금지원,컨설팅,교육을 중심으로
=기술 수용 모델 – TAM 모델
=논문에서 4.5.5절 가설 가설검증 결과 부분 참조
==무조건 상관계수가 높다고 인과가 밀접하다고 볼 수 없음
=국가 직무능력 표준으로 업무를 진행하기 위해 필요한 사항을 모듈화 시킨 것
중간고사 공지
=NCS 코딩데이터에 대한 R-Studio 실습 – Coding + 설명
=Working directory 설정 잘해야 에러 없이 제출이 가능하니 주의
=coding 산출물은 코딩file, 주석은 워드에
=결과값은 캡쳐할 필요 없음
=문제 & 코딩 image 넣기
상관 분석 – correlation analysis
=상관- 확률과 통계학에서 두 변수간의 어떤 선형, 비선형 관계를 가지는지 분석하는 방법
=상관 관계 – 변수간의 강도
==강도의 크기 – 보통 피어슨 상관관계를 가진다
=회귀 분석에서의 비독립 – 독립 변수간 관계가 0.8 이상 다중 공선성 – 독립이 가정이 안됨
=회귀분석 전에 상관 분석을 해야한다
=변수간의 관계 수치를 파악해서 시작한다
Excel을 이용한 data 분석
=상관관계를 –에서 +까지 확인
수업 example – 한국 창업학회 11권 1호 정화민 2016논문
=소기업 소상공인을 대상으로 서울시 기업 지원 정책의 효과성 여부, 자금지원,컨설팅,교육을 중심으로
=기술 수용 모델 – TAM 모델
=논문에서 4.5.5절 가설 가설검증 결과 부분 참조
==무조건 상관계수가 높다고 인과가 밀접하다고 볼 수 없음
2021년 3월 25일 목요일
Day_03. Regression
1.Regression 의 역사
=본뜻은 “옛날 상태로 돌아가다”
=부모-자식간 키의 상관 관계를 연구하여 전체 키가 평균으로 돌아가는 성질을 설명
2.Regression
=인과 관계를 나타냄
=독립변수(원인) 과 종속변수(결과)의 관계
=데이터를 바라보는 통찰력이 중요하다(무엇을 원인/결과 로 두어야 하는지)
3.Regression의변수
=사회과학적 많은 연구가 필요
=변수의 연관성, 원인, 결과, 제3의 요인 파악
=연구자가 주제를 선정 시 인과관계가 전혀 상관없는 요인이 있을수 있기 때문에 주의가 필요
==설명성을 대변하는 요인이 된다
===종속변수 – 변수에 의해 영향을 받아 그 값이 결정 되는 것
===독립변수 – ‘영향’을 미치는 변수
====영향의 양 - 영향력, 기울기, 미분값
 y절편,기울기를 설명 가능해야 한다
4.simple Regression analysis
=통계적으로 유의한 상황에서 독립변수(원인)은 종속변수(결과)에 영향을 준다는 의미
=보통 p-value가 0.05% 미만으로 나타난다
5.simple regression model analysis
=단순 회귀 모형에서 중요한 포인트는 y절편, 기울기, 결정계수 R^2(정확도) 이다
=편차 – 중심선(평균)에서 멀어진 거리
=분산 – 편차 제곱의 평균
=표준편차 – 분산에 제곱근
=F검정 – 회귀식 전체에 대한 유의성 검정 (p-value 0.05미만)
=T검정- 각 독립변수가 개별적으로 유의한 상황인지 확인
6.Multiple Regression – 다중 회귀 분석
=R과 Excel 을 사용한 예시 분석
Excel 을 활용한 분석


Excel을 활용한 simple Regression 확인

Excel을 활용한Multiple Regression
=본뜻은 “옛날 상태로 돌아가다”
=부모-자식간 키의 상관 관계를 연구하여 전체 키가 평균으로 돌아가는 성질을 설명
2.Regression
=인과 관계를 나타냄
=독립변수(원인) 과 종속변수(결과)의 관계
=데이터를 바라보는 통찰력이 중요하다(무엇을 원인/결과 로 두어야 하는지)
3.Regression의변수
=사회과학적 많은 연구가 필요
=변수의 연관성, 원인, 결과, 제3의 요인 파악
=연구자가 주제를 선정 시 인과관계가 전혀 상관없는 요인이 있을수 있기 때문에 주의가 필요
==설명성을 대변하는 요인이 된다
===종속변수 – 변수에 의해 영향을 받아 그 값이 결정 되는 것
===독립변수 – ‘영향’을 미치는 변수
====영향의 양 - 영향력, 기울기, 미분값

4.simple Regression analysis
=통계적으로 유의한 상황에서 독립변수(원인)은 종속변수(결과)에 영향을 준다는 의미
=보통 p-value가 0.05% 미만으로 나타난다
5.simple regression model analysis
=단순 회귀 모형에서 중요한 포인트는 y절편, 기울기, 결정계수 R^2(정확도) 이다
=편차 – 중심선(평균)에서 멀어진 거리
=분산 – 편차 제곱의 평균
=표준편차 – 분산에 제곱근
=F검정 – 회귀식 전체에 대한 유의성 검정 (p-value 0.05미만)
=T검정- 각 독립변수가 개별적으로 유의한 상황인지 확인
6.Multiple Regression – 다중 회귀 분석
=R과 Excel 을 사용한 예시 분석
Excel 을 활용한 분석


Excel을 활용한 simple Regression 확인

Excel을 활용한Multiple Regression

R을 활용한 Multiple Regression
=mtcars data사용(1974년 미국 Motor trend US magazine data)
Mtcars 변수 목록을 통한 예측
=mtcars data사용(1974년 미국 Motor trend US magazine data)
Mtcars 변수 목록을 통한 예측
| mpg - Miles/gallon (연비, 1갤런당 몇 마일을 가는가) cyl - Number of cylinders ( 차량 엔진의 실린더의 개수, 펌프같이 움직이는 것) disp - Displacement (배기량) hp - Gross horsepower (마력) drat - Rear axle ratio (후방 축 비율 wt - Weight (1000lbs) 파운드 기준 차량무게 qseq - 1/4 mile time 1/4 마일 간 시간? am - Transmission( 0 = automatic, 1 = manual) 변속기가 자동이냐 아니냐 gear - Number of forward gears 전진기어의 수? (1,2,3 ) carb - Number of carburetors 카뷰레이터 수 (기화기수) |
| ==어떤 변수가 “종속” 변수이고 “독립” 변수인가? --종속변수=연비mpg --독립변수=연비에 영향을 주는 요소중 가장 영향이 큰 부분은? |
| input <- mtcars[,c("mpg","disp","hp","wt")] print(head(input)) |
 |
| input <- mtcars[,c("mpg","disp","hp","wt")] model <- lm(mpg~disp+hp+wt,data=input) print(model) |
 |
| summary(model) |
 |
| 변수에 gear 부분 첨가 확인 input <- mtcars[,c("mpg","disp","hp","wt","gear")] model <- lm(mpg~disp+hp+wt+gear,data=input) print(model) |
 Gear 부분에 *이 붙어있지 않음을 확인 가능(영향도가 적다는 의미) |
2021년 3월 21일 일요일
Day_02. 표본 분포
용어정리


논문 작성의 단계
| 모수(parameter = 모집단의 특징 |
| 통계량(statistic) = 표본에서 나오는 표본의 특성 - 평균, 표준편차 , 중앙값 |
| 표본 분포(sampling distribution) = 표본조사를 실시하고 특성을 구하는 과정 |
| 편차 = 선형 회귀선에서 떨어진 정도 |
| 오차 = 모수 기준으로 멀어진 격차 |
Ex) 100명 학생의 수학 점수 평균은 70 표준편차는 9 학생 a는 80점일 때 등수는?
| pnorm(80, mean=70, sd=9) #0.8667397 #1-0.8667397 = 1-0.8667397 = 0.1332603 100 * 0.1332603 |
|
|
가설(hypothesis)
판정 오류 Diagram
| 영가설 | 귀무 가설 =기존에 알려진 것과 차이가 없음 대안 가설(대립가설)  =연구자가 밝히고자 하는 가설 =“연구가설” 이라고 한다, 기존에 알려진 것과 차이가 있다 |
| 가설 검정 | 정의 =모집단 특성의 상태에 대한 주장인 가설에 대해 표본으로부터 얻는 정보를 바탕으로 채택/기각 할지 판단함으로서 모집단의 상태를 결정하는 것 단계 =1단계-가설 수립(선행 연구 탐색) =2단계-표본으로부터 검정을 위한 통계량 계산(데이터 수집-설문) =3단계-가설 선택의 기준 수립(연구시 P-VALUE가 0.05%미만이여야 한다) =4단계-판정 |
| 가설검정 판정 오류 | =1종 오류 – 영가설이 참인데 대안가설을 선택(실제 유죄인데 무죄 선고) =2종 오류 – 영가설이 거짓인데 영가설을 선택(실제 무죄이나 유죄 선고) |
판정 오류 Diagram


논문 작성의 단계
| 가설 설정 |
| 이론적 근거(설문을 통한) |
| 선행연구 탐색 |
|
설문을 근거로 가설을 |
 까지 세우고 측정한 뒤 여부를 판단한다
Day_01. 기술 & 기본 통계
기술 통계학
=통계학의 “기술”은 Technique 이 아닌 Descriptive 로 해석과 요약에 중점을 둔다
=통계, 데이터를 설명하는 통계학의 한 분야
기초 통계량
=표본 평균, 분산, 표준편차, 수치 요약, 최빈값, 중앙값
R상에서 실습 코드
확률(probability)
=確率 – 굳을 확, 비율 률
=어떤 결정 등을 굳힐 비율
통계에서 확률
=동일 조건에서 같은 실험을 N번 반복
=사건 a가 모두 몇 회 발생 했는지 조사 = n
=사건 a가 발생할 확률
=주사위에서 모든 눈이 나올 확률은 시행 횟수 N이 많아지면 비슷해진다
확률 공리 – 공리적 확률
= 는 0과 1 사이의 값을 갖고

베르누이 실행
=P의 확률로 원하는 결과가 나타났을 때 ‘성공’으로 1-P의 확률로 그렇지 않은 결과가 나타났을때 ‘실패’로 하는 두가지 결과가 나타나는 확률 실험
이항분포
=성공 확률이 P로 동일한 베르누이 시행을 n번 반복해서 실험하는 경루
==실험이 n번 반복 되도 성공 확률 p는 변하지 않고 동일
==이항 분포의 모수
===n – 시행의 횟수
===p – 성공의 확률
정규분포
=종 모양 형태
=평균을 중심으로 좌우 대칭
=평균 중심에 모여있다 양끝에 적용
=표준 편차가 작으면 종이 예리하게 좁아진다
=표준 편차가 크면 종이 평평해진다
표준 정규분포
=평균이 0이고 표준 편차가 1인 정규 분포

Ex)표준 정규분포 예제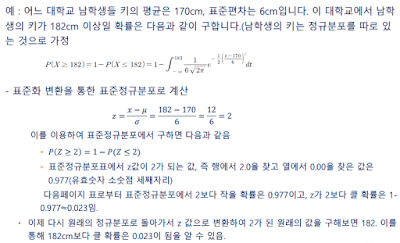
=통계학의 “기술”은 Technique 이 아닌 Descriptive 로 해석과 요약에 중점을 둔다
=통계, 데이터를 설명하는 통계학의 한 분야
기초 통계량
=표본 평균, 분산, 표준편차, 수치 요약, 최빈값, 중앙값
R상에서 실습 코드
| Code |
| #기초통계량 실습코드드 mean (1:4) #평균 var (1:4) #표본 분산 sd (1:4) #표준 편차 summary(1:4) |
 |
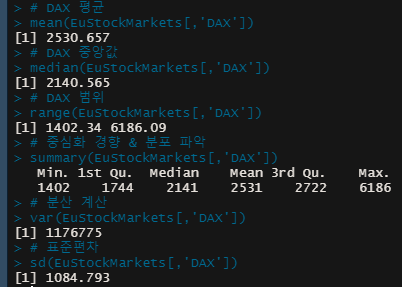
EuStockMarkets 의 기술 코딩
| # data set 사용 선언 data("EuStockMarkets") # data set structure 파악 (row , column) dim(EuStockMarkets) # data set 호출로 전체 데이터 파악 EuStockMarkets #전체 data 에서 'DAX' 변수에 해당하는 데이터 출력 EuStockMarkets[,'DAX'] summary(EuStockMarkets) # DAX 평균 mean(EuStockMarkets[,'DAX']) # DAX 중앙값 median(EuStockMarkets[,'DAX']) # DAX 범위 range(EuStockMarkets[,'DAX']) # 중심화 경향 & 분포 파악 summary(EuStockMarkets[,'DAX']) # 분산 계산 var(EuStockMarkets[,'DAX']) # 표준편차 sd(EuStockMarkets[,'DAX']) |
 |
확률(probability)
=確率 – 굳을 확, 비율 률
=어떤 결정 등을 굳힐 비율
통계에서 확률
=동일 조건에서 같은 실험을 N번 반복
=사건 a가 모두 몇 회 발생 했는지 조사 = n
=사건 a가 발생할 확률
=주사위에서 모든 눈이 나올 확률은 시행 횟수 N이 많아지면 비슷해진다
확률 공리 – 공리적 확률
=
 는 0과 1 사이의 값을 갖고

확률변수의 값의 종류
| 이산형 |
확률 질량 함수  |
| 연속형 |
확률 밀도 함수  |
베르누이 실행
=P의 확률로 원하는 결과가 나타났을 때 ‘성공’으로 1-P의 확률로 그렇지 않은 결과가 나타났을때 ‘실패’로 하는 두가지 결과가 나타나는 확률 실험
이항분포
=성공 확률이 P로 동일한 베르누이 시행을 n번 반복해서 실험하는 경루
==실험이 n번 반복 되도 성공 확률 p는 변하지 않고 동일
==이항 분포의 모수
===n – 시행의 횟수
===p – 성공의 확률
정규분포
=종 모양 형태
=평균을 중심으로 좌우 대칭
=평균 중심에 모여있다 양끝에 적용
=표준 편차가 작으면 종이 예리하게 좁아진다
=표준 편차가 크면 종이 평평해진다

표준 정규분포
=평균이 0이고 표준 편차가 1인 정규 분포


Day_00. Introduction – 강의 소개
교과목의 목표
=분석 목적에 따른 가설을 설정해서 필요한 데이터를 수집하고 모델을 생성하고 평가한다
교과목 특징
=단순 암기를 통한 시험이 아닌 Project 설계와 수행을 중심으로 하는 수업
데이터 분석의 특징이란?
=데이터의 특징과 같으며 생존 기술이 된다

**정화민.Dr research
한국인의 data 수집 DNA
=고대 측우기부터 시작된 데이터의 열정
==측우기
===조선초기 문종부터 조선 멸망인 20세기 초까지의 강수 기록이 남아있음
===”어떤 크기의 직경을 가진 그릇을 사용해야 하는가?”
===직경과 길이에 따라 얼마나 비가 왔는지 달라지기 때문이다
==팔만대장경
===5억자가 넘는 한자로 이루어 졌으나 오탈자가 한 개도 없는 특징
기업경영에서의 데이터 분석(Value chain 중심으로)
위를 기반으로 ERP, CRM 필요 요소 나열
미국의 JOB 추세
=미국 최고 직업에 DATA 과학자가 최상위에 랭크
=행동 예측 분석 분야가 최근 뜨고 있음
데이터 분야 확장 영역
=의료 영역까지 데이터가 잠식 하는 추세
=경험과 Algorithm을 통달해야 진입이 가능한 특징 존재
실생활에서 통계학의 사용
=크림전쟁의 장미도표
=전쟁에서 사상자보다 병원내 2,3차 감염에 의해 사망하는 비율이 높다는 것을 입증한 도표

통계학이란?
=통계학의 어원 – statistics = state(동사) + state(명사-국가) = 국가를 표시하다
=다양한 사회 현상에서 자료를 바탕으로 신뢰할 만한 정보를 제공하는 학문
모집단과 표본
공학 분야별 데이터 특징
통계학에서 데이터의 예시
자료 구분이 중요한 이유
=유형에 따라 사용되는 분석 algorithm이 다르다
==ex)혈액형과 MBTI 성격유형 이라는 논제에서 어떤 분석을 사용 해야 할지 구별 해야함
=분석 목적에 따른 가설을 설정해서 필요한 데이터를 수집하고 모델을 생성하고 평가한다
교과목 특징
=단순 암기를 통한 시험이 아닌 Project 설계와 수행을 중심으로 하는 수업
데이터 분석의 특징이란?
=데이터의 특징과 같으며 생존 기술이 된다

**정화민.Dr research
한국인의 data 수집 DNA
=고대 측우기부터 시작된 데이터의 열정
==측우기
===조선초기 문종부터 조선 멸망인 20세기 초까지의 강수 기록이 남아있음
===”어떤 크기의 직경을 가진 그릇을 사용해야 하는가?”
===직경과 길이에 따라 얼마나 비가 왔는지 달라지기 때문이다
==팔만대장경
===5억자가 넘는 한자로 이루어 졌으나 오탈자가 한 개도 없는 특징
기업경영에서의 데이터 분석(Value chain 중심으로)

위를 기반으로 ERP, CRM 필요 요소 나열
| ERP-전사적 자원관리 | 2, 6, 8, 재무회계 |
| CRM-고객 자원 관리 | 8, 9 |
미국의 JOB 추세
=미국 최고 직업에 DATA 과학자가 최상위에 랭크
=행동 예측 분석 분야가 최근 뜨고 있음
데이터 분야 확장 영역
=의료 영역까지 데이터가 잠식 하는 추세
=경험과 Algorithm을 통달해야 진입이 가능한 특징 존재
실생활에서 통계학의 사용
=크림전쟁의 장미도표
=전쟁에서 사상자보다 병원내 2,3차 감염에 의해 사망하는 비율이 높다는 것을 입증한 도표

통계학이란?
=통계학의 어원 – statistics = state(동사) + state(명사-국가) = 국가를 표시하다
=다양한 사회 현상에서 자료를 바탕으로 신뢰할 만한 정보를 제공하는 학문
모집단과 표본
| 모집단 | =알고자 하는 대상 전체 =조사 대상의 범위 =전수조사:모집단 전체를 조사하는 방법 |
| 표본 | =모집단으로부터 조사하기 위해 선택된 조사대상 =모집단 전체를 조사하는 것이 불가능 할 때 =수류탄과 같이 조사하면 사라지는 형태에서 사용하는 경우가 많음 |
공학 분야별 데이터 특징
| 공학-Engineering | 데이터의 양 =10TB이상 데이터의 특징 =데이터의 크기를 줄이는 것이 쟁점 |
| 사회공학 – Social Engineering | 데이터의 수 & 특징 =200건 이상에서 데이터의 특징 유추까지 |
통계학에서 데이터의 예시
| 변수유형 | 자료유형 | 인구주택 총조사 자료 | Ex |
| 질적 변수 | 명목형 | 성별, 배우자와의 관계 | 거주지, 혈액형 |
| 순서형 |
학력 |
학점, 설문문항 | |
| 양적 변수 |
이산형 |
출생아 수 | 형재 수 , 수강과목 수 |
|
연속형 |
연령 |
키, 몸무게 |
자료 구분이 중요한 이유
=유형에 따라 사용되는 분석 algorithm이 다르다
==ex)혈액형과 MBTI 성격유형 이라는 논제에서 어떤 분석을 사용 해야 할지 구별 해야함
피드 구독하기:
글 (Atom)