2021년 3월 14일 일요일

Day_10. Team build
Project 진행중 app구현 관련 Tip
=Adobe XD를 사용하면 Prototype을 만들 수 있음
데이터 소스 인정범위
=케글
=공공데이터
=깃헙
Day_09. Team Project 선정
=Bigdata를 활용한 BM 구축까지 진행
Project tip
=변수 중요성 분석 – random forest 분석방법이 좋음
=종합 시험에 Logistic 회귀분석은 필수로 나오니 열심히 하기
데이터 업계 흐름
=최고 수준의 data 엔지니어는 박사 과정이 필요하다
=기본적으로 통계는 잘해야 한다
Dendrogram
=계층적 군집의 결과와 계통도 분석
=k-mean의 k의 근거가 된다

Day_08. 데이터 전처리
=데이터를 원하는 형태로 변형, 분석에 적합한 형태로 가공하는 작업
=동일 용어- 데이터 가공, 랭글링, 머징
사용 R package
=dplyr
=데이터 처리에 특화된 R패키지,
=Data frame 처리하는 함수 집합
=”쉽게 하는 r데이터 분석” 참고
R 파이프 연산자
|
동치 조건등을 필터링 할 때 사용하는 것 |
| %>% (ctrl + shift + m)입력 |
| magrittr 또는 dplyr 패키지를 설치하고 로딩하면 됨 dplyr (디플라이어)가 짧고 범용적이니까 dplyr 를 기억해두자. 실제 %>% 연산자(함수)를 제공하는 패키지는 magrittr인데 dplyr를 로드(또는 설치)할 때 같이 된다. install.packages("magrittr") library(magrittr) install.packages("dplyr") library(dplyr) 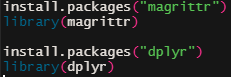 |
패키지를 사용하지 않으면 이렇게 나온다 |
| CSV 파일 읽기 |
| exam <- read.csv("D:/OneDrive/### Working/csv_exam.csv") |
 |
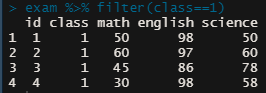
| exam 에서 CLASS 가 1인 경우만 추출 |
| exam %>% filter(class==1) |
 |
| exam 에서 CLASS 가 2인 경우만 추출 |
| exam %>% filter(class==2) |
 |
| exam 에서 CLASS 가 1이 아닌 경우만 추출 |
| exam %>% filter(class!=1) |
 |
| 수학 점수가 60점을 초과한 경우 추출 |
| exam %>% filter(math > 60) |
 |
| 영어 점수가 90점 이하인 경우 추출 |
| exam %>% filter(english <= 90) |
 |
| CLASS 가 1,3,5 인 경우 추출 ( %in% in 기호와 c() 함수 사용) |
| exam %>% filter(class ==1 | class ==3 | class==5) exam %>% filter(class %in% c(1,3,5)) |
 |
| CLASS 가 1,2인 ROW를 추출해 평균 구하기 |
| class1 <- exam %>% filter(class ==1) class2 <- exam %>% filter(class ==2) mean(class1$math) mean(class2$math) |
 |
| Select() 를 사용해 변수중 일부만 추출하기 |
| exam %>% select(math) #math 추출 exam %>% select(english) #english 추출 exam %>% select(-math) #math 제외 exam %>% select(-math,-english) #math, english 제외 |
| Arrange 함수를 사용한 데이터의 오름/내림 차순 정렬 |
| exam %>% arrange(math) #math 오름차순 정렬 exam %>% arrange(desc(math)) #math 내림차순 정렬 exam %>% arrange(class,math) #class와 math 를 오름차순 정렬 |
| 데이터의 파생변수 생성하기-1 |
| exam %>% mutate( total = math + english + science) |
 |
| 데이터의 파생변수 생성하기-2 |
| exam %>% mutate( total = math + english + science, mean =(math+english+science)/3 ) |
 |
| 데이터의 파생변수 생성하기-3-조건 달아서 pass,fail 확인 |
| exam %>% mutate( test=ifelse(science >=60,"pass","fail") ) |
 |
| 집단별 요약하기 – summarise() |
| exam %>% summarise(mean_math = mean(math)) |
 |
| 집단별 요약하기 – grooup_by |
| exam %>% group_by(class) %>% summarise(mean_math = mean(math)) == A tibble : 5x2 데이터가 5행 2열 tibble 은 데이터 프레임에서 기능이 추가된 것 == int : 정수 , dbl : 소수점이 있는 숫자(double,부동 소수점 |
 |
| 집단별 요약한 값의 추출 |
| exam %>% group_by(class) %>% summarise(mean_math = mean(math), sum_math = sum(math), median_math = median(math), n = n()) ==n() 은 데이터의 행으로 되어 있는지 빈도를 물어보는 기능으로 그룹으로 나누어 반별 학생빈도 추출 |
 |
데이터 요약하기
| Ggplot2의 mpg 데이터셋 사용 |
| install.packages("ggplot2") library(ggplot2) mpg %>% group_by(manufacturer, drv) %>% summarise(mean_cty = mean(cty)) |
| mpg데이터를 이용 하위 집단 별 평균 구하기 회사별로 집단을 나누고 다시 구동방식을 나눠 연비 산출하기 |
| mpg %>% group_by(manufacturer, drv) %>% summarise(mean_cty = mean(cty)) |
 |
| mpg데이터에서 회사-suv-통합연비-통합연비 평균을 내림차순으로 상위 5개 출력 |
| mpg %>% group_by(manufacturer) %>% filter(class=="suv") %>% mutate(tot=(cty+hwy)/2) %>% summarise(mean_tot = mean(tot)) %>% arrange(desc(mean_tot)) %>% head(5) |
 |
| 중간/기말 고사 점수 임의 생성 & 확인 |
| #중간고사 데이터 생성 test1 <- data.frame(id=c(1,2,3,4,5),midterm = c(60,80,70,90,85)) #기말고사 데이터 생성 test2 <- data.frame(id=c(1,2,3,4,5), final=c(70,83,65,95,80)) |
 |
| 생성된 데이터에서 id를 기준으로 합쳐서total 에 할당 |
| Left_join 을 활용한 가로 총합 |
| total <-left_join(test1,test2, by="id") |
 |
| 데이터 생성 |
| #학생 1~5번까지 데이터 생성 group_a <-data.frame(id=c(1,2,3,4,5),test=c(60,80,70,90,85)) #학생 6~10번까지 데이터 생성 group_b <-data.frame(id=c(6,7,8,9,10),test=c(70,83,65,95,80)) |
 |
| Bind_rows 를 이용한 데이터 세로 합치기 |
| group_all <-bind_rows(group_a,group_b) |
 |
| Column 개수가 안맞을 때 데이터 합치기 상황 |
| #학생 1~5번까지 데이터 생성 group_a <-data.frame(id=c(1,2,3,4,5),test=c(60,80,70,90,85)) #학생 6~10번까지 데이터 생성 group_b <-data.frame(id=c(6,7,8,9,10),test=c(70,83,65,95,80)) #학생 11~13번까지 데이터 생성 group_c <-data.frame(id=c(11,12,13),test_1=c(10,20,30),test_2=c(40,50,60)) |
 |
인공지능
| 정의 | 인지, 학습등 인간의 지적 능력의 일부, 또는 전체를 컴퓨터로 이용해 구현하는 것 |
| 파급효과 | 금융&보험 일자리의 81.8%가 사라질 위기 사람이 로봇을 관리하고 제어하는 방향의 노동시장의 성장 |
| 수준 | Level 1~4까지의 단계 |
인공지능 시대의 생존 전략
| 반복적인 작업을 하는 직업의 소멸 | 미국의 실리콘벨리의 인재상 |
| 머신러닝,통계전문 프로그래밍, 확률, 통계, 선형대수, 수학적 최적화 | |
| 프로그래밍 스킬=r,python,c,c++,java,tensorflow의 이해 | |
| 팀워크=여러 개의 팀을 구성해 실제 개발 수행팀을 짜고 결과를 통합하는 능력 |
국내 ai 기업의 특징
=보통 어떤걸 원하는지 기업 자체도 잘 모르고 AI, AI 등을 외치는 경우가 많음
시각화 방법중 쉽게 접근 가능한 방법 소개
=SOME.CO.KR
=빅카인즈(https://www.kinds.or.kr/)
=워드 클라우드 생성기 사이트 등
Day_07. 인공 신경망과 그 사례
=지도 학습의 분류(Classfication)의 일종
=회귀분석이 기울기가 인공신경망에도 그대로 이어지는 개념
| 딥러닝/ 머신러닝 / 인공지능 | |
|
|
|
|
딥러닝 |
XOR 문제의 해결 , CNN, LSTM, 이미지, 자연어 |
|
머신러닝 |
로지스틱 SVM , 수치형 DATA, 의료, ERP, 명목적 척도 |
|
인공지능 |
4단계의 Level , 중간 은닉층으로 인해 설명성이 떨어진다 |

인공신경망
|
개념 |
입력신호 x1,x2… 등의 입력신호(설명변수) 들을 중요도에 따라 가중치(w값)를 부여해 가중합을 계산하고 계산된 값에 활성함수(activation function)를 적용해 결과값 y를 출력하는 형태 |
| Diagram |
|
|
다층 퍼셉트론 |
활성함수(activation function)을 시그모이드 함수(로지스틱 함수)를 사용한 단층 퍼셉트론 신경망은 로지스틱 회귀 모형과 실질적으로 동일한 모델링이라 할 수 있음 |
|
Diagram |
|


인공신경망의 장 & 단 점 비교
| 장점 | 단점 |
| =선형으로 분류할 수 없는 복잡한 비선형 문제에 탁월한 성능 =분류 및 수치예측 문제에 모두 사용 가능 =통계적 기본 가정이 적고 유연하다 =데이터 사이즈가 작거나 불완전 데이터, 노이즈 데이터가 많은 경우에도 다른 모델에 비해 예측 성능이 우수한 경우가 많음 |
=모델 결과 해석이 어려워서 은닉층의 노드들이 무엇을 표현하는지, 왜 그런 결과가 나왔는지 설명이 필요할 때 사용하면 안됨 (블랙박스 모형) =나이브 베이즈나 로지스틱 회귀 모형 같은 보다 단순한 분류 알고리즘에 비해 컴퓨팅 연상에 많은 자원이 필요 =과적합화나 과소적합이 발생하기 쉬움 =전체적 관점의 최적해(Global min/max value)가 아닌 지역(logical min/max value)가 선택될수 있음 |
간단 용어 설명
=학습 데이터 – 검증시 파라미터 조정에 사용되는 데이터 셋
=테스트 데이터 – 이미 학습된 모델에 적용하는 데이터
=성능평가 – 얼마나 정확한가 살펴보는 검사
약한 / 강한 인공지능 소개
| 약한 인공지능 | 강한 인공지능 |
인간처럼 생각하는 시스템 =마음뿐 아니라 인간과 유사한 사고와 의사결정을 내리는 시스템=인지모델링 접근방식 |
합리적으로 생각하는 시스템 =계산 모델을 통해 지각, 추론, 행동 같은 정신적 능력을 갖춘 시스템=사고의 법칙 접근 방식 |
인간처럼 행동하는 시스템 =인간의 지능을 필요로 하는 어떤 행동을 기계가 따라하는 시스템=튜링 테스트 접근 =보고, 듣고, 움직이고, 운전하는 행동 |
합리적으로 행동하는 시스템 =계산 모델을 통해 지능적 행동을 하는 에이전트 시스템=합리적인 에이전트 접근 방식 |
인공지능에서의 지도 / 비지도 학습
| 지도학습 (Supervised Learning) |
특징, 결과 로 주어진 훈련 데이터로 학습 특징(feature)과 결과(label) 사이의 관계 모델링 새 데이터에 대해 학습된 레이블로 결과를 추출 ==분류. 회귀 |
| 비 지도학습 (Unsupervised Learning) |
특징만 주어진다 데이터의 특징을 모델링( ‘데이터 스스로 말하게 한다’) 주어진 데이터에 대해 기존 자료중 비슷한 군에 배치 ==군집화, 차원축소( 주성분분석) ==군집을 넣어주고(Clustering) k-means 처럼 사용한다 ==최후에는 business model 을 만들어서 사용해야 한다 |
종류별 해석성 / 정확도 diagram

| Source Code |
| # 인공신경망 은닉층수 1개 모형 install.packages("e1071") library(e1071) data(iris) install.packages("neuralnet") library(neuralnet) model_net <- neuralnet(Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data = iris, hidden=3) model_net plot(model_net) |
| Result |
|
|
| 은닉층 3개 은닉노드 각각 10개씩 증가 |
| Source Code |
| #은닉층 3개 모형에 은닉 노드를 10,10,10개 모형 library(e1071) library(neuralnet) model2_net <- neuralnet(Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data = iris, hidden=c(10,10,10)) model2_net plot(model2_net) |
|
|
| 은닉층 4개 은닉노드 10,4,4,4 모형 |
| Source Code |
| #은닉층 4개 모형에 은닉 노드를 10,4,4,4개 모형 library(e1071) library(neuralnet) model3_net <- neuralnet(Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data = iris, hidden=c(10,4,4,4)) model2_net plot(model3_net) |
|
|


Day_06. 중간고사 공지 & SVM
=다른 분류에 속하는 데이터간 간격(마진)이 최대가 되는선을 찾아서 데이터를 분류하는 모델

인공지능과 Bigdata 의 연관성
=예측, 분류는 지도학습의 밀접한 관계
=인공지능과 bigdata는 같이 학습이 진행되야 하는 것
|
SVM 의 활용 & 특징 |
=유전자 DATA의 분류 =언어식별 =보안결함 =이상치 거래 탐색 =과적합이 잘 일어나지 않는다 |
|
비선형 상태의 SVM |
|
|
1차원 DATA |
분류되지 않는다 |
|
2차원상 DATA |
분류가능 – 선형적으로 분리되게 만들어준다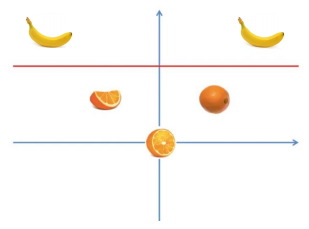
|
과적합 이란?
=많은 횟수의 학습으로 인해 실제 평가에서는 효율이 떨어지는 것
커널트릭
=선형으로 분류가 불가능할 때 차원을 증가시켜서 분류를 용이하게 하는 방법
수업중 소개된 관련 논문 제목
=SVM을 활용한 패턴인식 기법 – 신장범
=판별분석,인공신경망, SVM을 이용한 수익율 성능 비교 연구
데이터 분석 방법론 소개
|
KDD |
Knowledge Discovery Databases |
|
1.데이터셋 선택(Selection_) |
|
|
2.데이터 전처리 (preprocessing) |
노이즈, 이상값, 결측치 제거 |
|
3.데이터 변환 (Transformation) |
변수 탐색, 차원축소 |
|
4.데이터 마이닝 (Data
Mining) |
목적에 맞는 마이닝 기법 선택 |
|
5.데이터 마이닝 결과 평가 (Interpretation
/ Evaluation) |
해석 / 평가 |
| 데이터마이닝, 기계학습, 인공지능, 패턴인식 , 데이터 시각화에 사용 | |
|
CRISP_DM |
Cross Industry Standard Process for Data Mining |
|
1.Business Understanding |
업무 목표 수립 현재 상황 평가 마이닝 목표 수립 프로젝트 계획 수립 |
|
2.Data understanding |
초기 데이터 수집 데이터 기술(Discriminate) / 탐색 데이터 품질 검증 |
|
3.Data Preparation |
데이터 설정 / 선택 / 정제 / 생성 / 통합 / 형식 적용 |
|
4.Dmodeling |
모델링 기법 선택 테스트 설계 생성 모델 생성 / 평가 |
|
5.Evaluation |
결과 평가 프로세스 재검토 향후 단계 설정 |
|
6.Deployment |
전개 계획 수립 모니터링 / 유지보수 계획 수립 최종 보고서 작성 프로젝트 재검토 |
SVM 실습 in R
| Source Code |
| # svm (Support Vector Machine) install.packages("e1071") library(e1071) data(iris) samp <- c( sample(1:50,35), sample(51:100,35), sample(101:150,35)) iris.tr <-iris[samp,] iris.te <- iris[-samp,] m1 <- svm(Species~., data = iris.tr, kernel="linear") m2 <- svm(Species~., data = iris.tr, kernel="polynomial") m3 <- svm(Species~., data = iris.tr, kernel="radial") x <- subset(iris.te, selec=-Species) y <- iris.te$Species pred1 <- predict(m1, x) pred2 <- predict(m2, x) pred3 <- predict(m3, x) table(y, pred1) table(y, pred2) table(y, pred3) |
| Result |
> table(y, pred1) pred1 y setosa versicolor virginica
setosa 15 0 0
versicolor 0 15 0
virginica 0 0 15 > table(y, pred2) pred2 y setosa versicolor virginica
setosa 15 0 0
versicolor 0 15 0
virginica 0 7 8 > table(y, pred3) pred3 y setosa versicolor virginica
setosa 15 0 0
versicolor 0 15 0 virginica 0 2 13 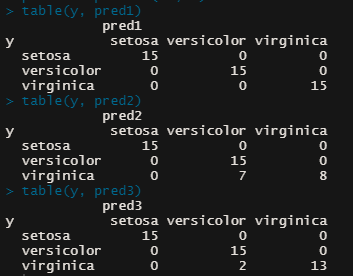 |
| Linear SVM = 데이터를 선형으로 분리하는 최적의 선형 경계를 찾아주는 알고리즘Radial SVM = 주어진 데이터를 구차원 특징 공간으로 이동시켜주는 것 , 원래 차원에서 보이지 않던 선형으로 분리해 줌 Polynomial SVM = 차수가 n인 다항식들이 관련되는 더 높은 차원에서의 서포트 벡터 머신 |
2020년 10월 11일 일요일
Day_05. 빅데이터 분석체계
빅데이터 분서체계 Level의 NCS 기준

빅데이터 직군에서 최상단은 “기획”
=Level-7수준, 현재 수업은 level 6수준이다
=기획은 BM을 만드는 직군이기 때문에 하단의 모든 업무를 알아야만 한다
=Level6는 전문가 그룹의 시작단계
=통계분야를 알아야 전문가 그룹으로 진입이 가능하다
지도학습과 비지도 학습의 가장 큰 차이
=지도학습은 Y값(목적변수)가 있으나 비지도 학습은 y의 값이 존재하지 않는다
분류목적의 Machine Learning
|
K-최근접 이웃(KNN) |
가장 비슷한 속성을 가지는 이웃을 근처에 둔다 |
|
Decision Tree |
의료부분에서 많이사용하는 방식 |
|
Random Forest |
의사결정 Tree를 모아두는 방식 |
|
인공신경망 |
회귀와 흡사함 |
|
SVM |
데이터 분류를 위한 구분선을 긋는 것 |
|
나이브베이즈 |
조건부 확률을 이용한 분류기법 |
Decision Tree 분류방식
=목표변수의 분류나 예측에 영향을 미치는 독립변수(x값,설명,입력변수) 속성 기준값에 의해 뿌리부터 확장된다
=수학적 지식이 없이도 이해가 쉽다
=분류의 차이를 보는 것으로 카이제곱이 사용딘다
=명목형 철도에 대한 분류가 잘된다
실습과정
|
IRIS 데이터(붓꽃)를 활용한 분석 – 꽃의 꽂잎,받침의 길이를 통해 품종을 분류, Decision tree 사용 |
|
Decision Tree 분석 실습 |
|
install.packages("party") library(party) data(iris) head(iris) samp <- c(sample(1:50,25),sample(50:100,25),sample(100:150,25)) #훈련용 데이터 생성 #1~50번에서 25개 , 50~100 번에서 25개 , 100~150 번에서 25개 추출 iris.tr <-iris[samp,] #훈련용 데이터 75개 iris.te <-iris[-samp] #검증용으로 훈련용에서 제외 iris_ctree <-ctree (Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data=iris.tr) plot(iris_ctree) x <- subset(iris.te,select=-Species) y <- iris.te$Species DT_pred <- predict(iris_ctree.x) table(DT_pred,y) |
 |
|
나이브베이즈 실습 =스펨필터, 문서분류,질병진단,고객 이탈 예측, 네트워크 진단 =빠르고 효과적인 분류능력을 가지는 성능 =확률값을 필요로 하는 상황에서는 사용할 수 없음 |
|
install.packages("e1071") library(e1071) data(iris) samp <- c(sample(1:50,35),sample(51:100,35),sample(100:150,35)) iris.tr <-iris[samp,] iris.te <-iris[-samp,] m <-naiveBayes(Species ~ .,data=iris.tr) pred <-predict(m,iris.te[-5]) table(iris.te[,5],pred) ##오류를 확인한다 |
 Versicolor 에서 0 13 1 을 보면 1건의 훈련이 실패한 것을 알수 있다 |
|
KNN-최근접 이웃 이미지와 비디오로 구성된 광학문자, 안면인식에 사용된다 install.packages("class") library(class) data(iris) y <-iris [,5] tr.idx <-sample (length(y),75) x.tr <-iris[tr.idx,-5] x.te <-iris[-tr.idx,-5] m <-knn (x.tr,x.te,y[tr.idx],k=3) yy <-y[-tr.idx] table(yy,m) ##오류율을 확인해야 한다 |
 Versicolor 의 0 22 1 에서 versicolor 지만 virginica 로 1 1개가 오류 Virginica 의 0 2 20 에서 virginica 지만 versicolor 로 2개가 잘못 판단되었다 |
2020년 10월 2일 금요일
Day_04. Multiple / Logistic Regression – 다중 , 로지스틱 회귀
회귀분석
|
2가지 변수(독립,종속)변수가 있음 x=독립/설명변수 y=반응/종속 변수 |
|
단순 회귀 분석 = 1개의 설명변수  다중 회귀 분석 = 여러 개의 설명변수  ==학력은 명목척도이다, 사용에 주의가 필요하고 대졸이상=1,고졸이하=0 등의 수치로 바꾼다 |
변수의 표현
|
사각형 = 단일변수 원형 = 다양한 변수의 묶음  |
Ex)연봉 근속년수, 학력을 이용해 다중/단순회귀를 실시하고 결정계수를 비교해 회귀공식 완성하기
|
데이터  단순회귀는 “연수”만 이용하고 다중회귀는 연수,학력을 동시에 이용한다 |
|
단순회귀 분석  |
|
다중회귀분석  |
논문 찾아보기
|
SAINT – 로욜라도서관 – RISS – 정화민 지역축제 논문검색  |

검색된 논문에서 표6을 보면

==”유의확률”이 0.05 미만에서 유의하기 때문에 행사 내용이 가장 중요한 부분임을 알수 있음
로지스틱 회귀분석
|
사용처 |
예측하고자 하는 목표변수(y)의 번주를 분류하기위해 사용 ==구매예측,신용평가 모형에서 사용 |
|
장점 |
단점 |
|
선형통계 이론에 기반하여 정교하고 체계적 추정이 가능 =확률모형이기 때문에 목표변수에 확률 추정 가능 =추정된 모형에 대한 해석이 가능 |
=Set의 차원이 많을 때 정확도에 문제가 발생한다 =x의 값이 매우 커지거나 작아지면 확률이 1이나 0에 매우 가까워짐 =반복 계산시 과적합 위험 =복잡한 비선형 분류에서 정확도가 낮음 |
논문 찾아보기


|
표1 = 빈도분석 |
  |
|
표3=분포차이 |
 |
|
표5 = p,
exp(b)값을 중요하게 봐야 한다 |
 |
R-studio 의 내장 데이터인 Mtcars 를 대상으로한 회귀분석 실습
|
이분형 회귀분석 (Binomial Logistic Regression 자동차 이진값인 am(자동/수동) 을 종속변수로 두고 실시한 회귀분석 |
|
변수 소개 Mpg= miles/gallon – 연비, 1갤런에 가는 마일 Cyl = number of cylinders - 차량 실린더 개수 Disp = displacement- 배기량 Hp = gross horsepower – 마력 Drat – rear axle ratio – 후방축 비율 Wt = weight - 1000파운드 기준 차량 무게 Qseq = 1/4 mile time Vs = ?? Am = transmission (0=auto 1=manual) |
실습 시작
|
input <- mtcars[,c("mpg","disp","hp","wt")] print(head(input)) |
 |
|
input <-
mtcars[,c("mpg","disp","hp","wt")] model <-
lm(mpg~disp+hp+wt,data=input) print(model) |
 |
mtcars 데이터 세트에서 이진값 am을 종속변수 hp,wt cyl을 독립변수로한 logistic regression
|
input <-
mtcars[,c("am","cyl","hp","wt")] print(head(input)) |
 |
|
input <-
mtcars[,c("am","cyl","hp","wt")] am.data =
glm(formula = am ~cyl + hp + wt,data=input,family = binomial) print(summary(am.data))
==am 뒤에 ~는 종속변수 표시 ==출력에서 *가 붙어있어야 유의간 값이다 ==wt의 –값은 무게가 무거울수록 나빠진다는 의미임 |
 |