레이블이 DATA_MINING인 게시물을 표시합니다. 모든 게시물 표시

2021년 3월 13일 토요일

Day_14. GAN 학습

GAN의 생성 방법 알고리즘 소개


G의 입장
=산출물이 1에 가까워야 한다
=오류율이 Min 에 가까워야 한다
=50% 정도면 사람들은


G의 학습
=D는 고정시킨다
=Weight 와 Bias는 학습하지 않는다
=진짜 확률이 0에 가까운 시기(기울기가 완만해 지는)가 있기 때문에 빠르게 탈출하는 방안이 필요하다

Dc gan
=Deep Convolution GAN
=CNN과 흐름이 반대로 진행


LSGAN
=손실함수에 Mean Square error 를 사용한다


Semi-supervised gan
=one Hot Vector 로 생성된 숫자에 대한 표시를 한다(이미지에 꼬리표를 단다)


ACGAN
=Semi-supervised GAN 처럼 동작


Cycle GAN
=진짜 이미지를 입력하고 가짜 이미지를 생성하는 것

2021년 3월 10일 수요일

Day_13. GAN

분별모델 vs 생성모델

생성모델(Genetative

벡터 X에 대한 확률분포를 추정

레이블 정보가 없는 비지도 학습

레이블 정보가 있으면 활용해도 되고 무시해도된다

분별모델(Discriminative

MLP , DMLP , CNN

특정 벡터 X의 확률 분포를 알아낼 필요없음

X는 주어진 것, 변수가 아닌 일종의 상수

X가 주어지고 Y를 추정한다


생성 모델과 분별 모델의 추정치와 예측

X1

0

0

0

0

0

1

1

1

1

1

X2

0

0

1

1

1

0

1

1

1

1


분별 모델이 추정하는 확률 분포 정리


실생활에서 사용하는 방식
=자연계에서 화률을 산정시 발생 분포를 확인 가능하다
=이때 명시적 방법으로 추정하는 것이 아닌 묵시적으로 추정한다


학습과 모델의 비교

Supervised Learning

f에 x를 넣으면 y가 나온다

함수 f를 찾기

Unsupervised Learning

Y는 없다 함수 f에 x를 넣고 추이를 봐서 z를 뽑는다

라벨이 없음

Generative model

X가 없다, 함수f는 있으며 출력 y가 있음

적당한 x를 생성


분석의 특징
=많은 분야에서 x가 월등히 많음(고차원)
=variable selection 을 통해 차원을 축소시킨다
=ex)6개의 변수가 있을 때 3개씩 묶어서 평균을 산정해 2개의 변수로 줄인다


PCA분석의 특징
=Y를 고려하지 않는다,
=PCA는 일종의 Unsupervised Learning 이다


Encoding VS Decoding
=변수 X에서 Y를 생성—Endocing
=결과 Y에서 x를 생성 – Decoding


Fake VS Real
=위폐를 찍어내는 기계와 비슷하다고 보면 된다
=Fake set의 분포가 real 과 흡사하게 만드는것이다


GAN의 목표 & 원리
=Discriminator(판독기)가 구별하지 못하는 수준까지 지속적으로 학습하게 하는것


최초 GAN 모델의 구조

=생성 G를 DMLP로 구현했음

=는 난수발생기로 만든 벡터 Z를 입력 받아서 가짜 이미지,영상을 생성

=는 판독기로 생성된 결과를 가짜, 진짜로 판독해준다


생성함수 G의 특징
=생성된 Fake image는 Discriminator가 구별하지 못하게 하기 위해 최대한 작은
를 요구

Day_12. 기말고사 & CNN & GAN

CNN의 전체구조
=초기 CNN 형태로 LeNet-5 형태가 있음
=C-P-C-P-C 의 5층을 통해 28*28의 명함을 120차원의 구조로 변환
=C-P-C-P-C-Fully Connected-Softmax 함수를 사용했음
=구조는 크게 문제되지 않음 Convolution – Convolution 만으로 구성해도 문제되지 않음

=역전파등의 단계를 거치면 Filter(커널)의 값이 바뀌게 된다
=filter는 역할이 세분화되고 고급 기능을 가진다


Image net
=20000개의 분류에 대해 분류별로 500~1000장의 이미지로 구성되어 있는 이미지 데이터셋


CNN 발전역사
=초기 – 이미지 판독이 대다수
=현재 – 영상을 인식하는 기술까지 발전해 영상에서 object를 찾아서 영역을 지정 할 수 있는 형태까지 발전


Deep Learning 이 강력한 이유
=고전적 방법 – 분할 – 특징추출 – 분류 를 따로 구현뒤 이어붙힌다
=새로운 방식 – 전체과정을 동시에 최적화(통째학습, end to end learning 이라 부름)
=많은 은닉층에 따른 표현력의 증가(hidden layer가 많으면 많을수록 전체 표현력이 좋아짐
=더 많은 노드를 통해 곡선의 표현이 완만히 잘 표현가능하다
=계층적 특징


Data별 특징

스냅샷성 data

이미지, 영상 = CNN

시퀀스성 data

음성, 언어, 주식가격, 언어적 맥락=RNN LSTM 사용


semi supervised learning
=전체중 x,y 모두 제공되는게 아닌 x는 모두, y는 일부 제공되는 것
=소실된 y값의 공간을 채워주는 방식의 학습

2021년 3월 9일 화요일

Day_11. CNN

컨볼루션 신경망 vs DMLP

종류

특징

ANN

=입력데이터의 구조를 고려하지 않아서 공간구조 데이터 처리에 나쁘다

DMLP

=Fully Connected – 완전연결 구조로 높은 복잡도를 가지고 학습이 느리며 과적합 우려가 높다

CNN

=컨볼루션 연산을 이용한 부분연결(최소 연결)로 수용장(Receptive field) 가 있음

=입력Sample 의 크기가 달라도 처리가 가능하다

=컨볼루션, 풀링층이 번갈아가며 존재한다

DMLP

=부분연결(Partially connected) = n개의 node가 set을 이룬다=수용장

=총연결개수 = 수용장 개수 * 다음층의 노드개수

=DMLP의 입력 SAMPLE은 항상 같은 크기를 가져야 한다

==pixel 의 수가 변하면 안된다


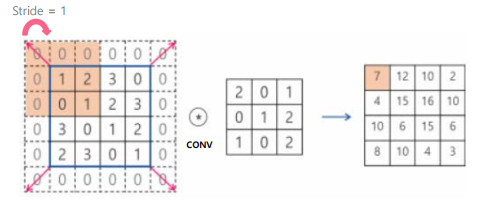
컨볼루션 연산
=해당 연산끼리 곱하고 더한것과 같다
=입력->커널,필터,윈도우(호칭은 다를수있다)->출력,특징맵(feature map)


패딩(Padding)
=가장자리에 덧대어 크기가 줄어드는 것 방지
=양끝에 0을 추가 복사해서 과적합(overfitting)을 방지한다


절편(Bias)
=모든 칸에 다 있음,커널의 맨 앞에 추가해서 사용한다
=Transpose 시에는 가로로 변화도 가능하다


스트라이드(Stride)
=입력된 데이터에서 필터를 곱하는데 왼쪽부터 이동해 얼마나 이동할지 정하는 간격

필터(Filter) 커널 추정
=특징이 data에 존재하는지 정의하는 것, 다수의 filter도 적용 가능함
=형태를 격자에 나타내서 표시한다

가중치 공유(weight sharing) 묶인 가중치(tied weight)
=입력계층에 적용되는 커널은 모두 동일한 set을 적용한다
=커널은 여러개 적용 가능하다


CNN의 특징
=이동에 동변(신호가 이동시그대로 특징맵에 반영된다(영상인식에서 물체 이동이나 음성인식에서 발음 지연에 효과적으로 대처한다


동변 vs 불변
=연산의 결과는 동변
=최종 인식은 불변


특징학습
=커널을 사람이 아닌 기계가
=표기시 로 표기(k번째 커널의 i번째 매개변수라는 뜻)
=CNN도 DMLP 처럼 역전파로 학습한다
=커널은 학습(추정) 해야할 가중치 매개변수와 동일하다


Stride에서 크기가 바뀌는 규칙
=Stride가 k면 k 마다 하나씩 샘플링 해서 적용
=2차원 영상의 경우 특징맵이로 작아진다


Tensor(컬러이미지)에도 적용
=컬러영상, 이미지는 rgb라는 3개의 채널을 가진다
=연산의 결과는 1개의 단일값이 나와서 feature map에 적용된다


3차원 구조데이터 적용
=차원(dimension)이 증가해도 단일값을 도출한다
=입력데이터와 커널의 채널수는 동일해야 한다
=커널은 정방행렬이여야 한다


Tensor로 표시하는 데이터의 특징
=동영상 data
=시간에 따라 화소를 차지하는 물체가 달라지므로 최소값은 꾸준히 변함
=컬러 동영상의 차원 = 3 * s * 가로pixel * 세로pixel = tensor 크기
=MRI 영상 차원(Dimension - 흑백) = 1 * s * 가로pixel * 세로pixel = tensor 크기
==컬러는 rgb라 3을 흑백은 1을 곱하는 것


빌딩블록
=CNN도 DMLP와 같이 여러 층을 이어붙혀 깊은 구조를 만들수 있다
=주로 활성화 함수(Activation Function)은 Relu 함수를 사용하고 풀링 연산을 사용한다

풀링연산
=컨볼루션 layer 다음에 적용(컨볼루션 layer결과에 relu같은 활성화 함수 적용후 풀링적용)
=결과의 noise를 제거해준다
=결과를 요약하기 때문에 메모리 효율에도 기여한다
=상세 내용에서 요약통계를 추출한다
=매개변수가 없고 특징맵의 수를 그대로 유지
=max 풀링시 물체 인식이나 영상 검색에 효과적이다
=출력 data의 크기를 조절하는 기능

=각 sector에서 가장 큰 값을 선정해서 출력한다

Day_10. DMLP

Deep Learning
=다중 퍼셉트론에 은닉층을 여러 개 추가한 형태
=딥러닝은 깊은 신경망을 학습시키는 알고리즘


Deep Learning 의 등장 근거와 특징
=1.고려해야할 변수가 많다
=2.컴퓨팅 비용이 저렴해진다
=3.깊이가 깊어진다
=4.계산은 단순하나 성능이 좋아진다


Deep Learning의 걸림돌

Gradient Vanishing

Sigmoid, Hyperbolic tangent 함수의 문제

=지속적으로 미분하면 0에 수렴하는 문제

==Relu 함수의 등장 근거가 된다

Overfitting

훈련데이터에 따라 과적합 상황이 발생할수 있다

Local minimum

그래프 상에서 확인 가능한 부분으로 일시적 최소값이나 전체의 최소값으로 확인해버리는 문제를 의미한다


활성화함수 종류와 특징

계단함수(step function)

로지스틱 시그모이드

하이퍼볼릭 탄젠트

Relu

=음수를 모두 0으로 만드는 특징으로 leaky lelu 등이 개발되었다


특징학습의 부각(feature learning)

고전적 패러다임

변수를 선택한다

학습을 진행한다

딥러닝의 패러다임

End to end learning

=통째로 데이터를 넣으면 자동으로 학습한다


특징학습(feature learning)
=여러단계의 은닉층이 자동으로 생성된다
=앞 단계의 은닉층은 엣지, 코너 같은 저급 특징을 추출한다(low level feature)
=뒷 단계의 은닉층은 추상적 형태의 고급 특징을 추출(high level feature)
===기존 보다 획기적 성능의 향상이 가능하다
=새로운 응용의 등장 – gen


Deep Multi Layer Perceptron

특징

=MLP에 Hidden layer를 추가한 형태

Hidden Layer의 수

L-1

표기법

입력층은 0번째, 출력층은 L번째 은닉층으로 간주한다,L번째 은닉층의 노드수를 표기시

노드간 가중치(weight)표기

L-1번째 층의 i번째 노드와 l번째 층의 j번째 노드를 연결하는 가중치

노드간 가중치(weight) 개수

L-1번째 층과 L번째 층을 이어주는 가중치 개수 산정 


DMLP의 학습방법
=MLP와 흡사
==DMLP는 그래디언트 계산과 가중치 갱신을 더 많은 단계에 걸쳐 수행하는 차이
=DMLP는 그래디언트 연산 + 가중치 연산으로 이루어진다


DMLP vs CNN
=CNN이 부상한 것은 확실
=CNN이 DMLP보다 확연하게 우월하다
==하지만 DMLP가 CNN보다 우수할 수밖에 없다는 “과학적 근거” 는 없다
==CNN의 매개변수가 훨씬 적어서 CNN이 더 쉽다는 설명만 가능할 뿐
==Deep Learning은 설명이 안되는 특징을 가지므로 정확성만 알 수 있다

Day_09. 다중퍼셉트론-용어, 흐름을 중심으로

신경망
=기계학습 역사에서 가장 오래된 학습모델
=1950년->퍼셉트론->1980년대 다중 퍼셉트론(Multi level Perceptron)


퍼셉트론의 한계
=XOR문제의 해결 불가 문제
=1990년대에는 SVM 모델에 밀리는 형국


신경망

신경망

모델

=Feed forward – perceptron

=Multi Level Perceptron

=Deep Multi level Perceptron


깊이

=얕은 신경망

(Hidden layer 1~2개)

=깊은 신경망

(Hidden Layer 2~3개이상)


논리

=결정론(deterministic) – 입력과 출력의 개수가 같다-RBM,DBM을 제외한 모든것

=확률론적(Stochastic) - d입력수와 출력의 수가 다르다 –RBM,DBM 방식, 유사한 패턴을 ‘생성’ 할수 있다

 Perceptron

Perceptron

특징

=입력과 출력층을 가진다( 입력층은 연산을 안하기 때문에 count하지 않는다)

=d개의 노드를 가지는 입력층의 i번째 노드는 특징벡터의 요소 xi다

=항상 1이되는 bias (절편) 노드는 x0=1

=출력은 1개

=가중치(weight)는 d+1개


동작

=입력층에 값이 들어오면 입력층에 해당하는 가중치 w와 곱한 결과를 모두 더해 s를 구하고 활성화 함수(Activation Function)을 적용


특징

=그래프상에서 독립변수의 개수가 3개 이상은 초평면(Hyper plain) 이라고 함


핵심

=그래프의 가중치(weight)를 찾는 것

=And OR 게이트 에서는 x(독립변수)가 2개뿐이였지만 현실에선? - d차원공간, 수만개의 sample 에서 어떻게 학습 할 것인가?

=최적의 목적함수를 찾기 위한 조건 J(w)=0 이 되게한다

=w가 최적이면 모든 샘플을 다 맞추면 J(w)=0이된다

=틀리는 샘플이 많은 w일수록 J(w)가 커지는것

=그라디언트 calculate 경사하강법을 사용


다중 퍼셉트론(MultiLayer Perceptron)
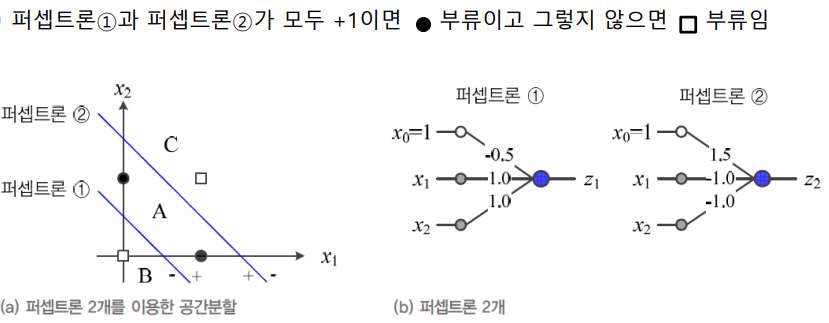
=퍼셉트론은 선형(Linear) 분류하는데 한계가 있다 –XOR 을 구분할수 없음

특징
=은닉층(Hidden Layer)를 둔다
=Sigmoid function(s형태의 함수 라는뜻) 을 사용한다
==계단함수보다 부드러운 형태


공간 분리의 soft hard 함수 분류
=hard – step(계단)함수
=soft - sigmoid, hyperbolic tangent – 모든 구간의 미분이 가능하다, 속도가 빠르다


Deep learning 의 특징
=logistic 이나 hyperbolic tangent를 많이 사용하면 종국에는 값이 0이된다, 이때 Relu 함수를 사용해서 이를 해결한다


Hyper parameter
=신결망 설계시 사용자가 지정하는 매게변수


Layer의 개수
=입력층은 count 하지않는다
=은닉층의 은닉 node를 몇 개로 할것인가가 중요, P가 너무크면 과적합, 작으면 과소적합


Layer에서 가중치 계수 확인


은닉층은 특징벡터를 분류에 유리한 특징 공간으로 변화하는 것
=feature extractor 가능


오류의 역전파 알고리즘
=error back propagarion algorithm

훈련집합=특징

훈련집합

특징벡터, 분류벡터로 분류,

분류벡터 표기-one-hot-code

사용하는 함수(step,sigmoid 등등)에 따라 0,-1 등이 다르다


기호표기 방식


기계학습의 목표

모든 sample을 옳게 분류하는 함수를 찾는다

가중치 업데이트 방식

온라인(stochastic), 배치 방식이 있고 미분의 용의성을 위해 앞에 1/2를 곱해준다


Mini-batch 방식
=효율적 연산을 위해 이전단계 값을 저장해서 사용한다
=순서를 섞기 때문에 sample 마다 빈도가 달라질수 있다
=batch와 스토캐스틱의 중간방식
=1회에 사용하는 sample 의 수를 저장해서 사용
=현대 기계학습의 중점기술


휴리스틱 알고리즘
=순수한 최적화 알고리즘으로는 높은 성능이 나오지 않는다
==원인=데이터 희소성,노이즈,잘못된 모델링
=학습을 이용해서 성능을 올린다, end-to-end 방식 사용

2021년 3월 5일 금요일

Day_08. 신경망 분석(Neural Network)

데이터의 종류
=범주형(이산형)자료-0,1등으로 나뉨
=연속형(수치형)자료=continuous)


Regression VS Logistic Regression
=Regression – y가 연속형
=Logistic – y가 0,1등의 범주형(연봉과 결혼 유무의 상관관계등에서 연봉이x, 결혼 유무가 0,1)


y가 연속,범주형 모두 적용가능
= Neural Network
= Decision Tree


신경망 모형 개요
=인간의 두뇌구조를 모방
=여러 개의 뉴턴 입력에 상응하는 결과가 나옴
==장점-정확도가 좋다
==단점-해석이 어렵다, Hidden Layer가 여러 개 있어서 부하가 있다

활성화 함수(activation function)
=생물학적 뉴런의 경우에는 마치 전구를 끄고 켜듯(0,1 상태) 어떤 조건이 되면 특정 뉴런이 활성화 된다


가장 많이 사용되는 활성화 함수
=sigmoid
=hyperbolic tangent


간단한 함수
=Linear(Identity)
=Threshold(step function)
=Gaussian
=Relu function


신경망 모형의 해석이 어려운 이유

=sigmoid 형태처럼 증가값 대비 y값의 변량이 크지않아서 해석이 어렵다
=함수에 붙어있는 요소가 많다


로지스틱 함수
=기계학습에서는 sigmoid 사용
=sigmoid 함수 특징 –결과가 0과 1 사이를 가진다

=hyperbolic tangent 함수는 -1과 1사이의 값에서 움직임

=0이하의 x값이 입력되면 결과값이 모두 0이 출력된다


출력층의 특징
=regression
==출력은 항등함수,identity function
=classification
==sofrmax function = y가 n개의 구분을 가질 때
==logistic function = y가 0,1일 때


함수의 기울기(weight)값의 변경을 막기 위한 방식
=Feed forward neural network
=Back propagation learning


역전파(back propagation) example
=예제 사진 첨부
=수업자료 68page backpropagation 참조

용어정리
==1 epoch –진행하는 횟수
==batch 1번에 학습하는 data의 개수


모형구축과정
=하나의 data에 대해 one pass = one forward pass + one backward pass 진행 –weight가 변경된다(w0->w1)
=2번째 data에 w1을 적용해서 w1이 w2가 된다
=마지막까지 반복해 wn을 생성하고 1epoch 가 종료된다
=각 w0~wn까지의 에러가 산정되고 이를 평균내서 에러를 산정한다
=순차적으로 하지않고 임의의 순서로 뽑아서 진행하기도 한다(순서의 영향을 벗어가는 방법)
=이떄 batch의 크기에 따라 한번에 적용하는 w의 값이 다르다, batch가 2면 2개씩 묶어서 w를 적용 w0, w1이 생기면 이를 평균내어 1개로 만든다


Epoch 의 핵심
=시작은 hidden node 없게 진행
=한번에 1개의 node만 추가
=error가 test set에 대해 많이 감소하면 멈춘다
=입력변수를 표준화 시킨다음에 함수를 적용한다


표준화를 진행해야 하는 이유
=함수마다 특징이 있기 때문
=활성화 함수마나 x에 대한 y의 변화가 다르다—sigmoid 함수의 경우 극한값에 대해 변화가 거의 없기때문


신경망 모형의 장단점 최종 정리
=장점
===좋은 예측 성과
===많은 데이터에도 안정적
===예측 변수와 반응변수간의 관계가 복잡해도 파악 가능

=단점
===블랙박스와 같은 모형의 구조를 설명하지 못함
===신경망은 변수선정 메커니즘을 자체적으로 가지고 있지 않음
===높은 유연성은 학습과정에서 많은 데이터를 가지고 있을 때 가능함
===학습 시간의 적절성이 중요함, 상대적으로 부하가 크기 때문에 학습 시간을 정하고 투입해야한다
===전역 최적점이 아닌 지역 최적점에 빠질 위험이 존재한다


Day_07. 회귀분석과 경사하강 알고리즘

선형회귀 모형 ->단순선형회귀
=독립변수 x가 1개 y값 대응
=dataset 을 가장 잘 표현하는 1가지 선을 찾는 행위
=오차(잔차, error residual)의 제곱을 더할 때 최소가 되는 직선->최소 제곱법


중선형회귀
=독립변수 x가 여러 개
=변수가 여러 개인 방정식을 푸는것과 같음


--나머지 세부 수식과 그래프 등은 컴퓨터로 표현이 어려워 옮겨 적지 않음

Day_06. 기계학습에서 수학의 역할

기계학습에서 수학이 중요한 이유
=기계학습의 근간은 수학이기 때문이다


기계학습에서 최적화 이론
=목적함수를 최적화하는 최적해를 찾는데 활용하며 주로 미분을 활용한 방안을 사용한다, 개발된 이론의 적용을 통한 개선이 반복된다


정보이론 (information theory)
=메시지가 가진 정보를 수량화 할수 있는가?
=”고비사막에 눈이 왔다” 와 “대관령에 눈이 왔다”는 메시지중 어느것이 많은 정보를 가지는가
=정보이론의 기본원칙à “확률이 작을수록 많은 정보를 가진다”


자기정보-self information
=확률변수 x의 정의역(사건이 일어날 가능성이 있는 영역) ex)주사위에서는 1~6까지
=사전(메시지) ei의 정보량 단위
==비트(밑이 2인 log ), 나츠(밑이 e인 log),
==확률이 1/2 일때 1비트의 정보를 가진다
=
=확률변수 x의 자기 정보량

엔트로피 – entity
=자기정보가 특정사건의 자기 정보를 나타내는 대신 모든사건 x에 대한 평균


Ex)주사위 던지기

눈(x)변수

1

2

3

4

5

6

P(x)확률

1/6

1/6

1/6

1/6

1/6

1/6

변수,정의역,확률변수(변수는 변수인데 각각의 확률값을 가지는 변수)


최적화 – optimization
=최저점을 만드는 x값을 찾는 것
=기계학습이 최적화되는 목적함수와 최저점을 찾는 것
=에러를 가장 작게만드는 것 찾기
=y=bx+a 에서 bias와 weight를 찾는 것


최적해 찾는방법
=최초 임의의 값에서 천천히 증가시킨다, 이때 오류가 가장 적은 것을 찾는 것


미분=순간 속도, 1차 도함수, f(x)를 1번 미분한 것, 함수의 변화율을 알려 주는것

===그래프 상에서 최저점을 찾는다


그래프(2차함수)가 가장 작아지는쪽을 찾는 것
=분석적방법 – 차원이 작을 때 바로 미분해서 찾는다
=수치적방법 – 차원이 높고 바로 미분이 안될 때 점진적 탐색, 기계학습에서 사용


편미분
=변수가 여러 개 있음, 변수 각각에 대해 독립적으로 미분
=편미분의 결과는 벡터가 되고 이 미분값 이후는 벡터를 그라디언트(gradient)라고 한다


연쇄법칙(chain rule)
=합성함수 f(x)=g(h(x)) 등의 미분
=안쪽부터 미분한다


아코디언 행렬
=d차원 벡터를 입력받아 n차워으로 바꿔준다
=여러 개의 함수를 모두 미분한다


해시인 행렬
=f를 두번 미분한 것
=대칭이 된다
=함수는 1개 변수는 여러 개


경사하강 알고리즘 =gradient descent algorithm

스토캐스틱 경사하강법
=하나의 sample 에 대해 그래디언트 산정(편미분)을 실시하고 즉시 변수를 갱신
=모든 sample 이 검사가 완료되면 1세대에 epoch 한다
=시간이 많이 든다


일반화 선형 모형

설명변수x / 반응변수y

연속형

범주형

연속형

선형회귀

로지스틱

범주형

분산분석(anova)

분할표분석

연속 + 범주

공분산, 선형회귀

로지스틱


신경망 = 정확성(높) 해석성(낮)
의사결정트리 = 정확성(낮) 해석성(높)
단순선형회귀 = 설명변수(x)가 1개밖에없음

2021년 3월 3일 수요일

Day_05. 목적함수의 정의 & 기계학습이 하는일

목적함수란?
=목표치를 출력해주는 함수
=평균제곱오차(MSE , Mean Squard Error)모형에서 예상한값- 실측값=잔차, 즉 잔차 제곱의 평균
=기울기와 절편이 하나 있는경우

기계학습이 하는일
=예측-실측값이 가장 작아지는 상황을 찾는 것


Ex) 수식의 그래프를 보면과 같이 그려지기 때문에 min f(x)=1 이기 때문에 이에 맞는 데이터 선별이 중요

기계학습의 목표

=낮은 bias 값과 분산을 가지는 예측기의 제작


바이어스 vs 분산 상대도표


검증 집합과 교차 검증을 이용한 모델 선택 알고리즘
=기존 Training set : test set = 7:3 비율
=training set : validation : test set = 검증집합을 추가
=hyper parameter가 등장하는 시점


교차검증 ( cross validation
=비용문제로 별도의 검증집합이 없는 상황에서 사용한다
=훈련집합을 등분해서 학습과 평가 과정을 여러 번 반복후 평균을 사용하는 것

0

1

2

3

4

5

6


=i번째 그룹을 제외한 것을 학습하고 i번째 그룹으로 검증하는 방식
=0번째에는 0번 그룹을 제외한 모든 1~6까지로 학습후 학습이 마무리 된후 0번째로 검증하는 방식


현대 기계학습의 전략
=용량이 큰 모델을 선택하고 선택한 모델이 정상을 벗어나지 않도록 여러가지 규제(regulation)을 적용한 기법을 사용하낟
=다양한 모델의 성능 검증에서 벌칙까지 더해서 에러율을 판단한다


규제(regulation)
정의=높은 일반화 능력(모형의 제작에서 다른 data set에 대한 성능이 좋은 것)을 확보하기 위한 방법은 용량이 큰 모델에 규제를 적용하는 것


데이터 확대
=데이터를 더 많이 수집하면 일반화 능력이 좋아진다


데이터는 어떻게 수집할까?
=데이터 수집은 소요 비용이 큰 작업이다, (사람이 data에 대한 labeling 이 들어가기 때문)
=인위적 데이터 확대 – 샘플을 변형, 데이터를 뒤집거나 회전(와핑,warping) 기법을 사용


가중치의 감쇠(weight decay)
=곡선의 굴곡이 매우 심하다
==극점에서 곡률(curvature)이 크다
=식의계수(기울기) 죽이는 방법
=기울기가 줄어드는 효과


벡터의 크기 계산하기


2차 함수에서의 기울기 특징
y값이 바뀌는 흔들림이 적어진다


기계학습의 유형

데이터 마이닝

Supervised learning


Classification

특징백터x

기계학습의 호칭=learning


X(설명변수)에 대한 y(반응변수)가 있다

Regression

목적함수 y

통계에서는 추정(estimation


Unsupervised learning

Clustering


강화학습
=목표값 (y)가 주어지나 목표의 형태가 지도학습과는 다른 형태로 주어진다
=바둑이나 장기에서 마지막에 이기면 1, 지면 0이 되게 하는 방식, 이때 1수를 set으로 두고 각 셈플열에 가중치를 주는 방식으로 설계
=알파고는 지도학습+ 강화학습을 동시에 사용해서 만들어냄

준-지도학습
=일부는 xy를 가지나, 나머지는 x값(독립변수)만 가지는 것
=일부만 table이 있음
=인터넷의 발달로 x값을 모으기는 쉬우나 y값(종속변수)은 수작업이 필요하다
=데이터의 분포로 판단을 지어주는 구분선을 만드는 것


결정론적 학습(determistic)
=동일데이터로 다시 학습하면 같은 예측기가 되는 현상
=대부분의 학습 알고리즘은 결정론적이다


Stochastic 학습
=결정론적 학습의 보완으로 난수를 더해주는 것
=데이터에 변화를 주는 것


분별모델 (discriminative model)
분류예측에 집중, 즉 p(y|x)의 추정에 목적을 둔다


생성모델 (Generation model) – p(x) 또는 p(x|y) 추정
=새로운 샘플을 “생성” 가능
=GAN, RBM 등이 있음


AI-인공지능-인간의 지능을 컴퓨터로 구현한다
Machine learning – 인공지능을 구현하기 위한 컴퓨터의 학습방법
Deep learning – Machine learning 을 실현하는 기술의 종류