레이블이 020000_DAY_00인 게시물을 표시합니다. 모든 게시물 표시

2020년 3월 19일 목요일

Day_00. Intro_06

Pandas pivot table
--group by 와 pivot table 의 차이점
----다차원(multi-demention)에서 작동
----data가 있을 때 어떤 기준으로 나누고 각 그룹의 수치의 값을 볼지 결정한다

** Titanic 의 생존자 data를 seaborn 에서 가져와서 실습해보자**
1. seaborn 에서 titanic 생존자 data를 가져오기
2. 성(sex)별생존자 를 계산한다
3. 선실별 등급(class) 과 성별의 생존률의 관계
4. 0,24,60의 나이대 그룹에서 생존 성별,등급
5. 0,24,60 의 나이대 그룹에서의 생존 성별 등급의 평균 좌석별 요금(fare)
6. 생존자의 총합, 요금의 평균값을 생성


seaborn 에서 titanic 생존자 data를 가져오기

import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
plt.style.use('seaborn')

titanic = sns.load_dataset('titanic',engine='python')
titanic


성(sex)별생존자 를 계산한다
titanic.groupby('sex')[['survived']].mean()

--여성과 남성의 생존률 평균치, 그런데 이때 여성의 생존률이 4배 이상이라고 결정지을수 있나?
선실별 등급(class) 과 성별의 생존률의 관계
titanic.groupby(['sex','class'])[['survived']].mean()
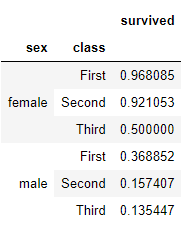
titanic.groupby(['sex','class'])[['survived']].mean().unstack()
---row base로 옆으로 펼친다

Pivot table로 구성하기
titanic.pivot_table('survived', index='sex', columns='class')

0,24,60의 나이대 그룹에서 생존 성별,등급
--3개의 그룹상황에서의 pivoting

age_div = pd.cut(titanic['age'],[0,24,60])
--원하는 나이 구간을 위해 생성한다
titanic.pivot_table('survived',['sex','age'],'class')
--age라는 column으로만 pivoting 할 때 상황

titanic.pivot_table('survived',['sex',age_div],'class')
--위에서 선언한 age_div를 이용해 구간을 적용함

0,24,60 의 나이대 그룹에서의 생존 성별 등급의 평균 좌석별 요금(fare)
--2개의 multi group 이 필요함

age_div = pd.cut(titanic['age'],[0,24,60])
fare_div = pd.qcut(titanic['fare'],2)
titanic.pivot_table('survived',['sex',age_div],['class',fare_div])


생존자의 총합, 요금의 평균값을 생성
titanic.pivot_table(index='sex',columns='class',aggfunc={'survived':sum,'fare':np.mean})


Day_00. Intro_05

Pandas groupy by 기능
-많은 data의 반복작업에 중요함
-column indexing 을 groupby에 사용하면 편리함
-Loop 를 사용하지 않고 group by를 사용하면 대용량 데이터 처리도 빠르게 할 수 있음

**seaborn package를 이용해서 실습**
--seaborn 이란? - python에서 matplotlib를 기반으로 만든 데이터 시각화 데이터셋

import numpy as np
import pandas as pd
import seaborn as 눈

planets = sns.load_dataset('planets')
planets.shape
---seaborn 에서 planets 데이터셋을 불러온다

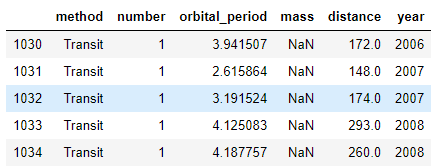
planets.head(1000)


planets.tail()

--head와 tail을 이용해 data를 살펴본다

planets.count()
planets.max()


---min(),mean(),std,var,mad() 등의 옵션이 가능함,

planets.columns
-- Index(['method', 'number', 'orbital_period', 'mass', 'distance', 'year'], dtype='object')
-----해당 dataset의 column의 이름을 추출해서 보여줌

Groupby를 이용한 column indexing
-- planets.groupby('method').groups


planets.groupby('method')['year'].describe()

planets.groupby('method')['year'].describe()
Filtering
--group by의 결과에서 특정조건에 맞는 data만 가져다가 사용 가능하게 하는 것

Apply
--groupby에서 결과에서 적용하는 특정값을 지정하는 것

**언제 apply, aggregate, filter, transform을 사용 해야하나**
--aggregate – 각 그룹의 단일값 사용
--filter row의 subset을 취할 때
--transform 각 row에 새로운 값을 넣을때

Day_00. Intro_04

Pandas concatenation
-pandas 에서 data frame의 combine 방법론
-기존 data에 새로운 data를 추가해서 붙히는 방법
-다른 데이터 소스에서의 데이터 병합, ex)quendl 과 yahoo 데이터등을 합칠 때
**암기가 아닌 응용력이 중요, 어떤 상황에서 어떤 문법을 사용할지 선택 하는게 중요**


import pandas as pd
import numpy as np

--x=[1,2,3]
--y=[4,5,6]
--np.concatenate([x,y]) ---array([1, 2, 3, 4, 5, 6]) #concatenate 를 full 로 작성해준다
**numpy에서는 concatenate 로 작성한다**

x=np.arange(1,7).reshape(2,3)
z=np.array([7,8,9]
---x를 1~6까지 2행 3열로 생성, z는 단일행 행렬로 7,8,9를 지정

np.vstack([x,z])
---array([[1, 2, 3],
[4, 5, 6],
[7, 8, 9]])
----vstack 을 이용해 x의 행렬 인 2행 3열에 맞게 z의 원소를 이어 붙힌다

Dataframe 의 축변환, (axis parameter를 이용하기)

-np.concatenate([x,x],axis=0)
--array([[1, 2, 3],
[4, 5, 6],
[1, 2, 3],
[4, 5, 6]])

-np.concatenate([x,x],axis=1)
--array([[1, 2, 3, 1, 2, 3],
[4, 5, 6, 4, 5, 6]])
--axis 가 0일때는 아래로 데이터를 연결, 1일때는 옆으로 이어붙힌다

Pandas 의 Merge
--공통된 항목ex)column name 이 있을 때 사용하기
--index 값으로의 concat 은 merge 기능이 좋다

x1=pd.Series(['A','B','C'],index=list('123'))
x2=pd.Series(['D','E','F'],index=list('123'))
x3=pd.concat([x1,x2])

x3
1 A
2 B
3 C
1 D
2 E
3 F


x3['1']
1 A
1 D

--pandas 에서는 concat 키워드를 사용해서 데이터를 붙힌다
--이때 index 가 이름이 중복되어있어도 상관없이 붙히는 것을 알수있음
--concat 된 데이터에 접근할 때 index의 이름을 1로 지정하면 같은 index로 지정된 데이터가 나옴


Merge- 다른 column 이름이나 원소의 개수가 같을 때 사용한다
--2개의 DataFrame 을 생성해서 merge 하기

df1=pd.DataFrame({'employee':['Bob','Jake','Lisa','Sue'],
'group':['Accounting','Engineering','Engineering','HR']})

df2=pd.DataFrame({'employee':['Lisa','Bob','Jake','Sue'],
'hire_date':[2004,2008,2012,2014]})

display(df1,df2)

pd.merge(df1,df2)

--2개의 dataframe 을 merge 한다
---pd.merge(df1,df2 , on='employee')
---이때 merge의 기준이 되는 column을 적어주면 혼잡도를 줄일수 있다

SQL 에서 Left outer join 기능 효과

df1=pd.DataFrame({'employee':['Bob','Jake','Lisa','Sue'],
'group':['Accounting','Engineering','Engineering','HR']})

df2=pd.DataFrame({'name':['Lisa','Bob','Jake','Sue'],
'salary':[10000,20000,30000,40000]})

display(df1,df2)
--dataframe 의 column이름이 다르고 추가된 항목도 있음


--2개의 dataframe 을 동시에 보기위해서 어떤 merge를 해야할까?
--pd.merge(df1,df2, left_on='employee',right_on='name')


문제점이 있는데 employee와 name 은 column이름만 다르고 내부 data는 같다
--pd.merge(df1,df2, left_on='employee',right_on='name').drop('name',axis=1)

--drop을 이용해서 중복되는 column을 제거하고 axis=1을 이용한다, 이때 axis를 사용하지 않으면 에러가 발생한다


Index를 따로 이름을 지정해서 표시하기
df1a=df1.set_index('employee')
df2a=df2.set_index('employee')
display(df1a,df2a)

이 상황에서 merge는 어떻게 해야할까?
--pd.merge(df1a,df2a)
#두개의 dataframe 은 공통된 column이 없어서 merge가 작동하지 않음

pd.merge(df1a, df2a, left_index=True, right_index=True)
--left_index , right_index


2020년 3월 18일 수요일

Day_00. Intro_03


Pandas 소개(Introduction)
 numpy에서 파생된 package
 data에 label 가능
 소실 data 핸들링
 Data grouping
 Data pivoting


설치방법
--pip install pandas
--conda install –c conda-forge pandas

데이터 관리 방법
--serise=1개의 column
--data frame= 여러 개의 column 관리

시계열 데이터 생성 예시
-import pandas.util.testing as tm
-df_mock =tm.makeTimeDataFrame()
-df_mock.head(5)


series –단일행 column data- 생성하기
import numpy as np
import pandas as pd

a = ['a','b','c']
x = [1,2,3]
ds=pd.Series(x,index=a)
ds

a 1
b 2
c 3
dtype: int64

--Serise 로 생성할 때 데이터로 지정할 행을 앞에, index로 사용할 행을 뒤에 index 키워드로 지정한다, 이때 복수의 column을 data 행으로 지정하면
TypeError: __init__() got multiple values for argument 'index'
가 발생한다

series –단일행 column data- 접근하기
ds['a'] #index 첫번째 항목 지정
ds['a':'c'] #index a항목부터 c항목까지
ds[0:2] #index 번호로 0번부터 지정

dataframe-복수행 column data- 생성
ps1=pd.Series(data=[11,22,33],index=['a','b','c'])
ps2=pd.Series(data=[55,66],index=['d','f'])


ps1a 11
b 22
c 33
dtype: int64


ps2d 55
f 66
dtype: int64

==ps1,2 로 이루어진 series data 를 2개 생성한다

agg=pd.DataFrame([ps1,ps2])
agg
==agg 로 생성한 dataframe 이 2개의 series를 묶어준다
 ---------------------------------------------------------------------------------------
Yahoo finance 의 정보를 가져와서 활용해보기
 Yahoo finance 정보를 가져오는 packages를 설치해야 할수있다

1.anaconda navigator 를 open하고 두번째 environments tab에서 rootàopen terminal 을 클릭


2.pip install yfinance –upgrade –no-cache-dir 을 입력해서 설치한다


**cmd에서 pip 으로 설치하면 SSL 에러가 발생하는 경우가 많기 때문에 Anaconda navigator 로 설치하면 편함

import yfinance as yf #yahoo 정보를 가져 오기 위해 import 한다
data = yf.download("TSLA", start='2010-01-01') #Tesla 의 data를 2010-01-01부터 취득
data.head()


data.to_csv("TSLA_2010-01-01.csv") #데이터를 csv파일로 저장한다, jupyter notebook 시작 경로에 저장됨

data.index.weekday #weekday를 기준으로 index를 잡음,month 도 가능

Int64Index([1, 2, 3, 4, 1, 2, 3, 4, 0, 1,
2, 3, 4, 0, 1, 2, 3, 4, 0, 1],
dtype='int64', name='Date', length=2446)

DataFrame 생성
-Series 키워드 명시
--pd.DataFrame({'A':pd.Series([1,2,3]),'B':pd.Series([5,6,7])})

-Series 키워드 비명시
--pd.DataFrame({'A':[1,2,3],'B':[4,5,6]})
-기존 생성한 Series 를 이용한 DataFrame 생성
 --pd.DataFrame({'A':ps1,'B':ps2})
DataFrame에 Access
 --DataFrame 생성
 -df=pd.DataFrame({'A':[1,2,3],'B':[4,5,6]},index=[2017,2018,2019])
-df
--Series이름을 통한 Access
-df['A']
--DataFrame 을 통한 Access
-df[['A']] #[]를 2개 사용하면 DataFrame 으로 판단된다
--Index 이름의 직접 명시
-df.loc[2017] #loc를 이용하면 해당 index이름을 직접 지정해서 접근이 가능함
--index의 번호를 지정해서 접근, -1은 맨뒤에 있는 항목
-df.iloc[:,0]
-df.iloc[:,-1]


DataFrame Renaming 방법 –column & index 의 re-naming

-df.columns = ['z', 'k']
Df
Homework
--Financial data download and manipulations
---1.data download
---2.close and close-return plotting
---3.correlation among downloaded data


import yfinance as yf
demo=yf.download("AMZN",start='2010-01-01')
demo


2020년 3월 17일 화요일

Day_00. Intro_02


Numpy stochastic process
 Numpy, pandas, matplotlib, seaborn 등 package import후 실습 수행
 시뮬레이션이란?-경제학등의 모형에서 과거 data가 있을 때 미래를 추정하는 것

Geometric Brownian Motion

데이터가 특정 시점에서 다른 시점으로 변하는 값, Delta value

위험비율

시간에 상관없이 변화하는 비율

numpy에서 random 하게 변하는 값

--이 장의 중점
----geometric Brownian motion 의 수식을 numpy로 가져와서 분석해보기
--적용예시
----xx기업의 주사= 기존 예측 성장세 + 기대하지 않은 변동성 값,(국제정세등으로 변하는 알수 없는 값)

Black-scholes-merton model 의 구현


시작값(initial value)

지정한 시간까지

증가비

변동성

기간

랜덤값

 수식을 기반으로 numpy 를 이용한 구현

import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

rng = np.random.RandomState(123)

T = 2 # years
r = 0.05 #constant short rate
sigma = 0.25 #constant volatility
S0 = 100 #initial value
I = 1000 # number of random draws
M = 50
dt = T / M
S = np.zeros((M+1,I))
S[0] = S0
for t in range(1 , M+1 ):
    S[t] = S[t - 1] * np.exp((r - 0.5 * sigma ** 2) * dt
                             + sigma * np.sqrt(dt)  * rng.standard_normal(I))

plt.hist(S[-1], bins=50)
plt.xlabel('index level')
plt.ylabel('frequency')


plt.plot(S[:,:10],lw=1.5)
plt.xlabel('time')
plt.ylabel('index level')
plt.grid(True)


나중에 추가로 해보면 좋은 것
-Stochastic volatitiy model
--변동성이시간에따라 변할 때 사용되는 모델로 20년전에 이론이 확립되어 사용중인 모델
-Option model